سوليوود «خاص»
خلال الأعوام القليلة الماضية، نجحت مولدات الفيديو بالذكاء الاصطناعي في الاقتراب كثيرًا من صناعة صورة مبهرة، فأصبحت قادرة على إنتاج مشاهد تحتوي على شخصيات وأماكن وإضاءة وحركة تبدو، في أفضل حالاتها، أقرب إلى اللقطات السينمائية مما كان ممكنًا قبل سنوات قليلة، لكن الصورة الجميلة ليست بالضرورة تصويرًا سينمائيًا جيدًا، فمدير التصوير لا يختار اللقطة القريبة لأنها تبدو أجمل فقط، ولا يحرك الكاميرا لمجرد إضافة الحركة، وإنما ترتبط الزاوية وحجم اللقطة والعدسة والحركة بما يحدث داخل القصة، وبما ينبغي أن يشعر به المشاهد في هذه اللحظة وبما شاهده قبلها.
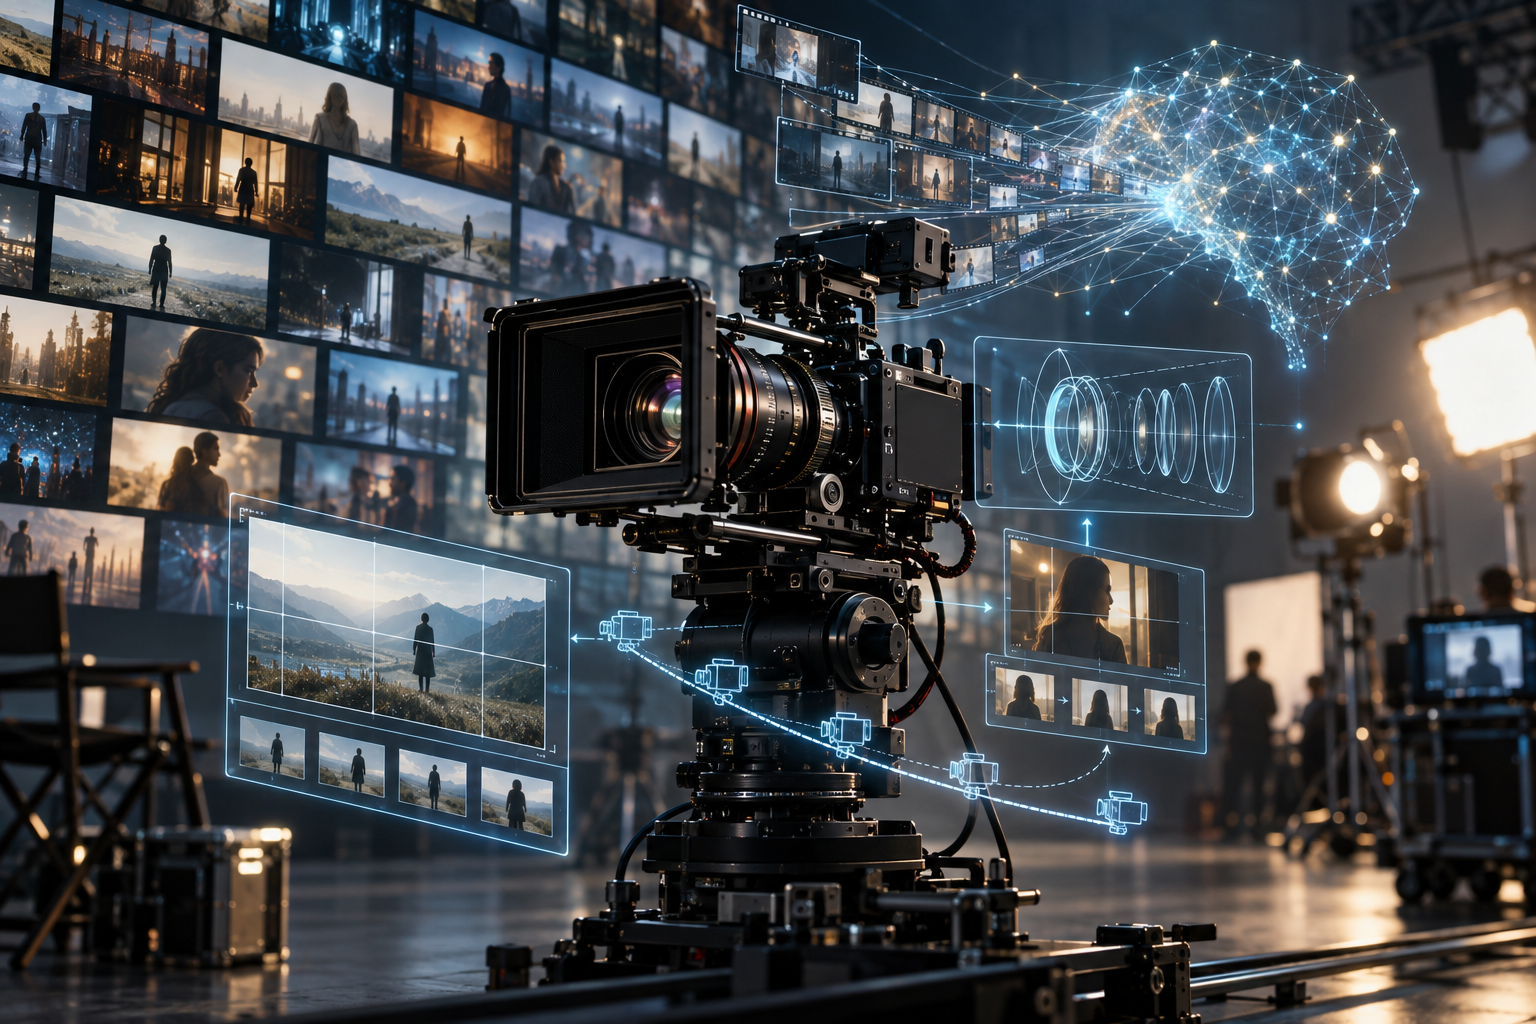
هذه هي المشكلة التي يحاول بحث حديث بعنوان «CamPilot: A Multi-Agent Cinematic Assistant for Camera-Controlled Movie Generation» التعامل معها، إذ لا يقدم مولد فيديو جديدًا بقدر ما يحاول إضافة طبقة من التخطيط السينمائي قبل عملية التوليد نفسها، بحيث لا يُطلب من النظام فقط إنشاء مشهد، وإنما التفكير في كيفية تصويره، وتحديد موقع الكاميرا وحجم اللقطة وحركتها وسلوك البعد البؤري وعلاقة هذه القرارات بما سبقها من لقطات.
المشكلة ليست في الصورة وحدها
يمكن لمولد فيديو أن ينتج لقطة جذابة تقنيًا لكنها بلا وظيفة درامية واضحة، وقد يختار حركة كاميرا مثيرة بصريًا من دون سبب، أو ينتقل بين لقطات تبدو كل واحدة منها جيدة منفردة بينما لا تبدو مجتمعة وكأنها تنتمي إلى المشهد نفسه. ومن هنا ينطلق «CamPilot» من منطق قريب من عملية صناعة الفيلم نفسها، فالمشهد لا يتحول مباشرة إلى فيديو، بل إلى سلسلة من القرارات المتعلقة بكيفية تقديمه بصريًا.
يستخدم النظام عدة وكلاء للذكاء الاصطناعي، يبدأ أحدهم بتوسيع الوصف الأولي للمشهد وتحديد أجوائه ومقصده السردي، ثم يحوله آخر إلى مجموعة من اللقطات، قبل أن يأتي الجزء الأهم، وهو مخطط عمل الكاميرا الذي يحدد زاوية التصوير وحجم اللقطة والحركة والبعد البؤري، مستفيدًا من سياق المشهد ومن اللقطات السابقة. وبعد توليد الفيديو، يراجع النظام النتيجة ويستطيع تعديل بعض قراراته وإعادة المحاولة إذا لم تحقق اللقطة ما كان مخططًا لها.
كما يحاول النظام التعامل مع واحدة من أكثر مشكلات الفيديو المولد وضوحًا، وهي فقدان الاستمرارية بين اللقطات، فيحتفظ بمعلومات عن الشخصيات ويستخدم بعض عناصر اللقطة السابقة للمساعدة على جعل التالية أكثر اتصالًا بها. ولا يعني ذلك أن كل مكونات النظام تعلمت صناعة الفيلم من الصفر، فالتدريب يتركز أساسًا على الجزء المسؤول عن تخطيط الكاميرا، بينما تعمل بقية المكونات من خلال تنظيم قدرات نماذج وأدوات موجودة بالفعل.
ماذا يعني أن يتعلم من 14 ألف فيلم؟
قول إن النظام تعلم من نحو 14 ألف فيلم لا يعني أن الذكاء الاصطناعي شاهدها كما يشاهد طالب تصوير أعمال كبار مديري التصوير ثم فهم لماذا اتُخذ كل قرار، وإنما بنى الباحثون قاعدة بيانات تستخرج من الأفلام أنماطًا مرتبطة بعمل الكاميرا وتحولها إلى معلومات يمكن للنموذج أن يتعلم منها.
تضم مجموعة البيانات التي طورها الباحثون أكثر من 14 ألف فيديو مأخوذ من أفلام احترافية، جرى تقسيمها إلى عشرات الآلاف من اللقطات، ثم تحليل خصائصها البصرية والسردية وعمل الكاميرا داخلها. واستخدم الفريق نماذج رؤية ولغة لوصف ما يحدث في المشهد وتصنيف جوانب مثل زاوية الكاميرا وحجم اللقطة وطبيعة الحركة، وهو تفصيل مهم لأن النظام لا يتعلم «السينما» بصورة مجردة، وإنما يتعلم من تمثيل منظم للقرارات الموجودة في المواد التي دُرب عليها.
وهنا تظهر أولى حدود الفكرة، فاللغة السينمائية لا تعمل كقاموس ثابت يقول إن الحزن يعني لقطة قريبة وإن التوتر يعني كاميرا متحركة، بل تتغير الاختيارات بحسب أداء الممثل، وحركته داخل المكان، والإضاءة والعدسة والإيقاع والأسلوب العام للفيلم، ولذلك فإن ما يتعلمه «CamPilot» هو جزء يمكن نمذجته من هذه اللغة، وليس اللغة السينمائية بكل تعقيدها.
الكاميرا تتحول إلى قرارات قابلة للتعلم
لكي يستطيع النظام التخطيط، كان على الباحثين تفكيك عمل الكاميرا إلى عناصر قابلة للقياس، من بينها زاوية الكاميرا وحجم اللقطة ونوع الحركة والبعد البؤري وسرعة الحركة وشدتها. ثم يتعلم النموذج العلاقات بين هذه القرارات والسياق الذي تظهر فيه، ولا ينظر إلى كل لقطة باعتبارها حالة معزولة، بل يحاول ربطها بما سبقها.
هذه الفكرة مهمة لأنها تنقل الذكاء الاصطناعي خطوة أبعد من مرحلة كتابة تعليمات مثل «لقطة قريبة» أو «حركة بطيئة إلى الأمام»، فبدل أن يحدد المستخدم كل شيء بنفسه، يحاول النظام اقتراح بعض هذه القرارات بناءً على المشهد وسياقه، أي الانتقال من تنفيذ تعليمات الكاميرا إلى محاولة التخطيط لها.
لكن هذا لا يعني أن هناك قرارًا واحدًا «صحيحًا» لكل مشهد، فالسينما بطبيعتها تسمح بعدة حلول بصرية للموقف نفسه، وقد يختار مخرجان مختلفان تصوير المشهد ذاته بطريقتين متناقضتين ويكون كلاهما مقنعًا، ولذلك فإن نجاح النظام في تعلم الأنماط لا يعني امتلاكه حكمًا جماليًا مستقلًا.
هل تحسنت النتيجة فعلًا؟
وفق الاختبارات التي قدمها الباحثون، استطاع «CamPilot» تحسين دقة قرارات عمل الكاميرا مقارنة بعدد من طرق التخطيط الأخرى، كما أظهر تحسنًا في بعض المؤشرات المتعلقة بالاستمرارية والجودة البصرية. واستخدم الفريق مولد فيديو واحدًا بصورة أساسية حتى يستطيع فصل أثر التخطيط السينمائي عن اختلاف قدرات مولدات الفيديو نفسها.
لكن هذه النتائج تحتاج إلى قراءة هادئة، لأن جزءًا مهمًا من التقييم يعتمد على مقاييس آلية، وليس على مجموعة كبيرة من مديري التصوير والمخرجين الذين يشاهدون اللقطات ويحكمون على ما إذا كانت الخيارات تخدم الدراما فعلًا. ويقر الباحثون بهذه المحدودية، ويشيرون إلى الحاجة إلى تقييمات بشرية أوسع، لأن بعض أكثر قرارات التصوير أهمية يصعب اختزالها إلى رقم أو تصنيف.
الاتجاه أكبر من «CamPilot»
لا يأتي البحث من فراغ، بل ينتمي إلى اتجاه أوسع في أبحاث الفيديو التوليدي يحاول الانتقال من سؤال «كيف نصنع فيديو مقنعًا؟» إلى سؤال أكثر صعوبة هو «كيف نبني تسلسلًا بصريًا يستخدم منطق السينما؟». فقد ظهرت أبحاث أخرى تحاول تعليم النماذج تصميم اللقطات، وربطها بالسرد، والحفاظ على الإيقاع والاستمرارية بين المشاهد، وهو ما يشير إلى أن المرحلة التالية من تطوير الفيديو بالذكاء الاصطناعي قد لا تركز فقط على جودة الصورة، بل على القرارات التي تجعل مجموعة من الصور فيلمًا.
ما يميز «CamPilot» داخل هذا الاتجاه هو التركيز المباشر على عمل الكاميرا ومحاولة جعله عملية منظمة يمكن تخطيطها وتقييمها، فإذا تطورت هذه الفكرة، قد يصبح مولد الفيديو أقل اعتمادًا على قدرة المستخدم على كتابة سلسلة طويلة من التعليمات التقنية، وأكثر قدرة على اقتراح كيفية تصوير المشهد قبل تنفيذه.
مدير التصوير لا يختار العدسة بالأرقام فقط
هنا يظهر السؤال الأهم بالنسبة إلى صناع السينما: هل يستطيع النظام أن يفهم لماذا ينبغي أن تكون الكاميرا هنا أصلًا؟ الإجابة حتى الآن محدودة، لأن مدير التصوير لا يتخذ قراراته من قائمة منفصلة للزوايا والعدسات والحركات، بل داخل علاقة مستمرة مع المخرج والممثلين والإضاءة والديكور والموقع والميزانية والوقت، وقد يكون القرار الأكثر تعبيرًا في بعض الأحيان هو كسر النمط الذي تعلمه الجميع.
كما أن جودة التخطيط لا تضمن دائمًا جودة التنفيذ، فقد يقترح النظام حركة كاميرا مناسبة بينما يعجز مولد الفيديو نفسه عن تنفيذها بدقة، أو يحافظ على الحركة لكنه يفقد ثبات الشخصية أو المكان، لذلك تظل جودة النتيجة النهائية مرتبطة أيضًا بقدرات نموذج التوليد المستخدم.
وهذا هو السبب في أن وصف «CamPilot» بأنه «مدير تصوير آلي» سيكون مبالغة، فالنظام يستطيع تعلم أنماط وقرارات متكررة واقتراحها وتنظيمها، لكنه لم يثبت أنه يمتلك الحس الإبداعي الذي يسمح بفهم متى يجب اتباع القاعدة ومتى يصبح كسرها هو القرار الأفضل.
من كتابة التعليمات إلى مراجعة اللقطة
بالنسبة إلى المخرجين ومديري التصوير، ربما تكون القيمة الأهم لهذا النوع من الأبحاث في شكل أدوات المستقبل لا في فكرة الاستبدال، فمولدات الفيديو الحالية تضع عبئًا كبيرًا على المستخدم الذي يحتاج إلى وصف اللقطة والحركة والعدسة والاستمرارية وتكرار هذه العملية عبر عدد كبير من المشاهد، بينما يقترح «CamPilot» نموذجًا مختلفًا يمكن فيه أن يبدأ الإنسان بالمشهد ومقصده، ثم يقترح النظام مجموعة من خيارات التصوير ليقوم المخرج بمراجعتها وتعديلها أو رفضها.
إذا تطورت هذه الأدوات، فقد تصبح أقرب إلى مساعد افتراضي للتخطيط البصري، يقترح قائمة لقطات أو حركات كاميرا أو حلولًا للانتقال بين المشاهد، بينما يبقى القرار الإبداعي النهائي في يد صانع الفيلم. وفي هذه الحالة لا تختفي مهارة المخرج أو مدير التصوير، لكنها قد تنتقل جزئيًا من كتابة كل تعليمات التنفيذ إلى الحكم على المقترحات وصياغة الأسلوب الذي ينبغي للنظام أن يتبعه.
لهذا فإن أهمية «CamPilot» لا تكمن في أنه أثبت إمكانية تعليم الذكاء الاصطناعي «التصوير السينمائي» بصورة كاملة، فهو ما يزال بحثًا حديثًا ولم يتحول إلى أداة إنتاج تجارية مثبتة، وإنما في السؤال الذي يدفع إليه، فقد بدأت مولدات الفيديو بمحاولة تعلم كيف تصنع ما يوجد أمام الكاميرا، ثم انتقلت إلى محاولة الحفاظ على الشخصيات والأماكن عبر اللقطات، والآن تبدأ الأبحاث في الاقتراب من سؤال أكثر تعقيدًا: أين ينبغي أن تكون الكاميرا أصلًا، ولماذا؟
وإذا كانت المرحلة الأولى من الذكاء الاصطناعي التوليدي قد انشغلت بصناعة الصورة، فإن المرحلة التالية تبدو منشغلة شيئًا فشيئًا باللغة التي تربط الصور ببعضها، وهذا هو الفارق بين لقطة تبدو سينمائية وفيلم يعرف لماذا اختار هذه اللقطة دون غيرها.


